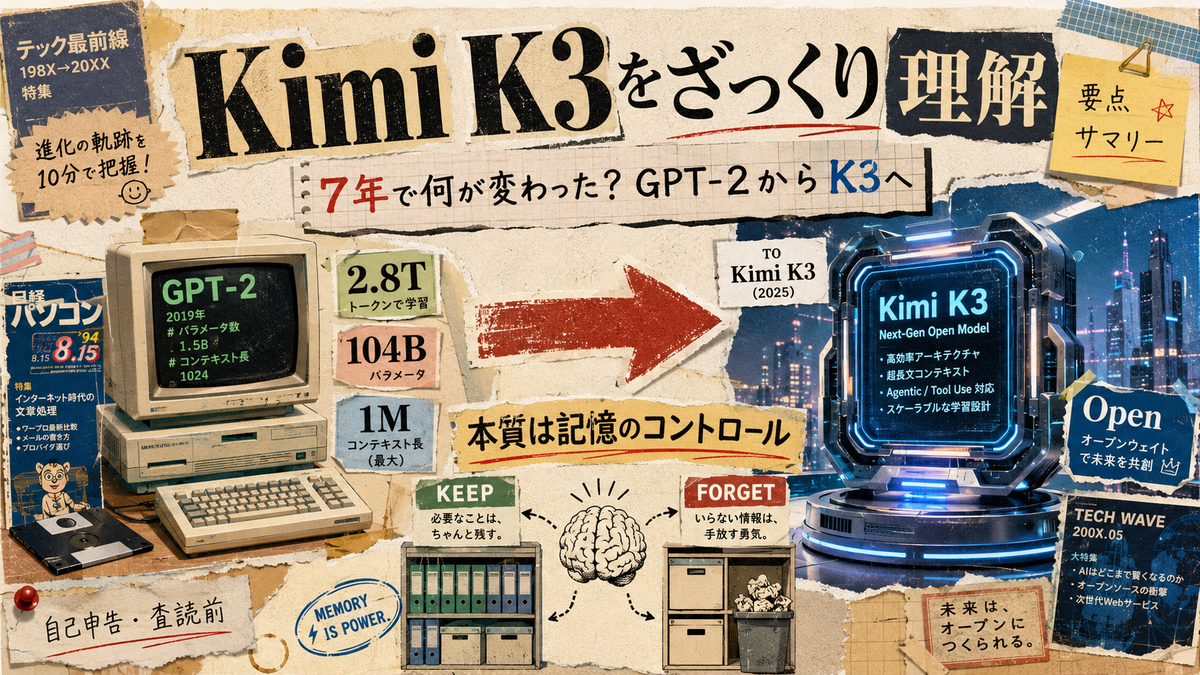
今回、2.8兆パラメータのオープンモデル「Kimi K3」の技術報告書を読みました。数字を並べるだけの記事にはしたくなかったので、「GPT-2 から7年でいったい何が変わったのか」という補助線を引きながらこの記事では整理しています。
先にお断り:本記事が扱う Kimi K3 技術報告書は査読を経ていない技術文書で、掲載された数値はすべて開発元(Kimi Team)の自己申告です。評価スイートには自社の内部ベンチマークも含まれます。第三者による追試で確認されたものではない、という前提でお読みください。
§0まず要点だけ
ひとことで言えば、世界初のオープンな 3T クラスモデルです。2026年7月末の時点で、重みは HuggingFace でフルリリースされています。
ただし報告書は自ら「総合性能では Claude Fable 5 と GPT-5.6 Sol に依然として及ばない」と明記しています。この率直さは、あとで見るベンチマークの読み方にも効いてきます。
§1なぜ今「3兆パラメータ(3T)」なのか
まず、LLM のスケーリングを二つの軸で整理します。①事前学習に投じる計算量と、②推論時の計算量(test-time computation)です。
②は OpenAI o シリーズ、拡張思考モデル、DeepSeek-R1、Kimi K1.5 などによって急速に発展し、いまやフロンティア研究の中心になりました。ここまではよく聞く話です。
用語のメモ:「o シリーズ」とは OpenAI の推論特化モデル群(o1、o3 など)のことです。報告書は「o シリーズは強化学習と推論時の思考をスケールさせた」と位置づけています。
同じ文脈で Anthropic の拡張思考モデル(思考予算を状況に応じて配分し、推論とツール利用を織り交ぜる)、そして DeepSeek-R1 や Kimi K1.5(大規模な強化学習によって、強い事前学習モデルから高度な推論のふるまいを引き出せることを示した)が並べて挙げられています。つまり②の軸は、特定の1社の工夫ではなく業界全体の潮流だ、というのが著者の見立てです。
実は、研究の課題はその先にあります。オープンソース陣営は②では進んだのに、①では遅れている。「最近の多くのモデルは 1T クラス、あるいはそれをやや上回る程度に留まっている」というわけです。
同規模の事前学習基盤の上に、より洗練された推論・エージェント RL を積み上げ続ければ、オープン側の進歩は収束し、最強のプロプライエタリとの差はむしろ開いていく。— 報告書 §1 の問題意識(要約)
「最強のプロプライエタリとの差」とは何か。報告書が具体名を挙げているのは Claude Fable 5 と GPT-5.6 Sol の2つで、総合性能ではこの2つに及ばないと自ら認めています。
ここで言われているのは、要するに土台の差です。推論時の工夫(②)は、あくまですでにできあがったモデルから引き出せる能力を伸ばすもの。だから土台(①)を 1T クラスに据え置いたまま②だけを磨き続けても、どこかで頭打ちになる。しかもクローズド側は①と②を両方伸ばしてくる。結果として、オープン側の到達点だけが先に収束してしまう——という課題感です。
だから K3 は両軸を同時に押し上げた — 事前学習を 3T クラスへ、かつ 1M 文脈で RL と長期対話をスケールさせる。これが「Open Frontier Intelligence」という副題の回収です。
この整理そのものが一番の収穫でした。「中国のオープンモデルが伸びている」という話は事実ですが、すでに真の課題を見出しているようです。
§2K2 から K3 で、何がどれだけ変わったか
報告書の Table 1 に、前世代 Kimi K2 との比較が載っています。数字で見ると、幅・深さ・疎性を同時に押し上げているのが分かります。
| 項目 | Kimi K2 | Kimi K3 | Δ |
|---|---|---|---|
| 層数 | 61 | 93 | ↑52% |
| 総パラメータ | 1.04T | 2.78T | ↑167% |
| 活性化パラメータ | 32.6B | 104.2B | ↑220% |
| ルーテッド・エキスパート数 | 384 | 896 | ↑133% |
| トークンごとの活性エキスパート | 8 | 16 | ↑100% |
| アテンションヘッド | 64 | 96 | ↑50% |
| 学習時コンテキスト長 | 128K | 1M | 8× |
| アテンション機構 | MLA | Hybrid KDA–MLA | 変更 |
| 活性化関数 | SwiGLU | SiTU-GLU | 変更 |
| ViT | — | 401M・27層 | 新規 |
隠れ次元(7,168)と語彙サイズ(160K)は据え置きです。むやみに全部を大きくしたわけではない、という主張が読み取れます。
この3点の合わせ技で、K2 比のスケーリング効率が約 2.5 倍になったと報告されています。Fig.7 のスケーリング則曲線を見ると、この 2.5× は横軸(FLOPs)方向の差として示されています。つまり「lossが2.5倍良くなった」ではなく、同じ検証 loss に到達するのに必要な計算量が約 1/2.5 で済む、という意味です。
学習レシピの面でも、K3 は最初から言語と視覚を一緒に最適化するネイティブ・マルチモーダル方式を採っています。事前学習済みの言語モデルに後から視覚エンコーダを接ぎ木してアラインメントする、という手順を踏んでいません。単なる大型化ではなく「効く場所に容量を足した」という主張は、こうした設計の積み重ねに支えられています。
§3研究の作法として唸った所 ——「公平な比較」の徹底
この報告書でもっとも再利用価値が高いと思ったのは、実は性能の数字ではなく、学習率スケジュールの比較に関する、たった数行の記述です。
前提のメモ:「学習率スケジュール」とは、学習を進めるあいだ学習率(1回の更新でパラメータをどれだけ動かすか)をどう変化させるかの計画のことです。
ここで比べられているのは2方式。cosine decay はコサインカーブを描くように滑らかに下げ続ける方式、WSD(Warmup-Stable-Decay) はしばらく一定に保ってから最後に落とす方式です。
先行研究では WSD が cosine decay に匹敵、あるいは上回ると報告されている。しかし我々は、両者の最適ハイパーパラメータが著しく異なることを観測した。同じモデルサイズ・同じ学習トークン予算でも、最適なピーク学習率とバッチサイズが実質的に違う。
結果として、共通のハイパラ集合で両者を比較すると、たまたまそのハイパラに合っている側が不当に有利になりうる。公平な比較のため、各スケジュールについて独立にスケーリング則探索を実施した。— 報告書 §3.2(要約)
言い換えると、こういうことです。
たとえるなら、2台の車の速さを比べるのに、両方へ同じギア比を強制するようなものです。そのギア比がたまたま片方の車に合っていれば、そちらが速いのは当たり前で、それは車の実力の比較になっていません。
そこで著者はそれぞれの方式について、別々に最適な設定を探し直してから比べました。その上で走らせると、cosine decay のほうが一貫して低い最終 loss に到達した — というのが結論です。
つまり「条件を揃えて比べる」ことが、かえって不公平になりうる。手間はかかりますが、比較の主張をするなら本来はここまでやる必要がある、ということです。
ベンチマークを作る側・読む側の両方にとって、これは効く話だと思います。「同一条件で比較しました」は一見フェアに見えますが、その条件が誰かに有利に働いていないかまでは保証していない。自分がベンチマークを設計するときにも、そのまま持ち帰れる論点でした。
§4Post-training は RL が主戦場
学習後の工程は3段階です。SFT でコールドスタートを作り、RL で「3ドメイン × 3つの推論努力レベル = 9つのエキスパート」を育て、最後に多教師 on-policy 蒸留(MOPD)で単一モデルへ畳み込みます。
用語のメモ
SFT(Supervised Fine-Tuning/教師あり微調整):お手本となる対話や作業ログを見せて、そのとおりに振る舞えるよう学習させる段階。「型を教える」工程です。
RL(Reinforcement Learning/強化学習):良い結果に報酬を与え、モデル自身に試行錯誤させて伸ばす段階。お手本のない領域でも上達させられる代わりに、設計を誤ると報酬を稼ぐことだけがうまくなる(報酬ハッキング)。
蒸留(distillation):できあがった複数の「先生モデル」の振る舞いを、1つの「生徒モデル」に写し取ること。ここでは9体の専門家を1体に畳み込むために使われています。
ただし Fig.8 は軸に数値の目盛りが振られていません(縦軸は Score(%) と Avg. steps、横軸は RL FLOPs というラベルのみ)。したがってこれは「右肩上がりである」ことを示すトレンド図であって、定量的な図ではありません。どれだけ計算を投じたか、どれだけ伸びたかの絶対値は読み取れません。
細部で面白かったのは次の3つです。
「良し悪しを判断せよ」ではなく「採点基準を先に作らせてから採点させる」という順序が肝で、これは評価系を作るときにそのまま真似できる形です。
さらに「長く書けば高評価」という報酬ハッキングを防ぐため、出力長が σ·ℓ₀ を超えた候補は二値比較で自動的に負けになる、という冗長性の予算制御も入っています。
§5ベンチマーク ——「抜いた」の中身を見る
報告書の Fig.1 には12のベンチマークが載っています(すべて thinking effort を最大にした条件)。結果を数えると 1位が4件、2位が6件、3位が2件でした。
| ベンチマーク | Kimi K3 | 順位 | トップ |
|---|---|---|---|
| ProgramBench | 77.8 | 🥇 1位 | —(K3 が首位) |
| SWE-Marathon | 42.0 | 🥇 1位 | —(K3 が首位) |
| BrowseComp | 91.2 | 🥇 1位 | —(K3 が首位) |
| AutomationBench | 30.8 | 🥇 1位 | —(K3 が首位) |
| Terminal-Bench 2.1 | 88.3 | 🥈 2位 | GPT-5.6 Sol 88.8 |
| FrontierSWE | 81.2 | 🥈 2位 | Fable 5 86.6 |
| Kimi Code Bench 2.0(自社内部) | 72.9 | 🥈 2位 | Fable 5 76.9 |
| JobBench | 54.3 | 🥈 2位 | Fable 5 57.4 |
| CharXiv (RQ) w/ tool | 91.3 | 🥈 2位 | Fable 5 93.5 |
| Zerobench w/ tool (Pass@5) | 41.0 | 🥈 2位 | Fable 5 46.0 |
| DeepSWE | 67.5 | 🥉 3位 | GPT-5.6 Sol 73.0 |
| GDPval-AA v2(Elo) | 1686 | 🥉 3位 | Fable 5 1747 |
この表から読み取れることが3つあります。
- 1位を取った領域が、はっきり偏っている。SWE-Marathon(長期ソフトウェア開発)、BrowseComp(エージェント検索)、AutomationBench、ProgramBench — いずれも長期実行・エージェント系です。一方で総合的な職務遂行を測る GDPval-AA v2 では3位。つまり「1M 文脈で長期に動かす」という設計の狙いと、勝っている領域がきれいに一致しています。
- 自社の内部ベンチでも負けている。Kimi Code Bench 2.0 は自前のベンチマークですが、そこでも Fable 5(76.9)に対して 72.9。自分が勝つようにベンチを作っていない、という点は報告の姿勢として誠実だと感じました。
- SWE-Marathon は全体的にスコアが低い。首位の K3 でも 42.0、GPT-5.5 は 14.0、GLM-5.2 は 13.0。長期ソフトウェア開発は、現時点でどのモデルもまともに解けていないということです。裏を返せば、ここは伸びしろが大きい。
⚠️ 数値の扱いに注意。報告書は「Fable 5 の結果はすべて potential fallbacks を伴う」「GPT-5.6 Sol の結果はすべて potential cyberguards を含む」と明記しています。公開版の仕様上やむを得ない条件ですが、厳密な等条件比較ではありません。
また、SNS では「中国が米国を抜いた」と要約されがちですが、正確には「特定のベンチマークで上回った、ただし総合では依然として差がある」です。報告書自身がそう書いています。
§6GPT-2 → Kimi K3 ——「スケールだけじゃない」の中身
ここからが、特に、一番面白かったところです。
7年でおよそ 22,580 倍のスケールアップ。
なお、この 22,580 という数字は K3 の「総パラメータ 2.8T」と GPT-2 small(124M)を比べたものです。K3 は MoE なので1トークンあたりに実際に動くのは 104B。それでも約 840 倍ですが、「22,580倍」を額面どおり計算量の比と受け取ると過大評価になります。この点も含めて、次の話につながります。
この数字を掲げた worklog "From GPT-2 to Kimi3" の問いは、「それは単にスケールなのか?」でした。そして GPT-2 から K3 までのアーキテクチャの変遷を追っていくと、一本の筋が見えてきます。
固定容量の記憶には、追い出し(eviction)のポリシーが要る。
話の出発点は、身も蓋もない事実です。系列はいくらでも長くなるのに、記憶に使える容量は有限。この緊張関係を、どこでどう引き受けるかで設計が分かれます。
標準的な Softmax Attention は「全部そのまま覚えておく」という力技でこれを回避します。過去のトークンごとに専用の置き場(KV キャッシュ)があるので干渉は起きない。代わりに、覚える量が増えるほどメモリと計算が膨らんでいきます。
そこで登場したのが Linear Attention です。固定サイズの状態行列に足し込んでいくことで、系列がどれだけ伸びても記憶のサイズは一定に保てる。ただしここで代償が生まれます。同じ場所に足し続ければ、過去の記憶どうしが混ざって取り出せなくなるのです。
この問題を、worklog は Schlag らの Fast Weight Programmers 論文を引いて説明しています。要旨はこうです —— 系列長が容量を超えると、モデルは「容量オーバー」の状態に入る。そこで正しく動くには、記憶の中身とやりとりして、どの対応づけを残しどれを消すかを自分で決められなければならない。ただ足し続けるだけの命令はこの目的に適さず、有限の記憶に無限に足し込めば必ず限界に達する。
つまり「どう書き込むか」ではなく「どう消すか」が本丸になったわけです。ここから先の系譜は、その消し方の解像度を上げていく歴史として読めます。
| 世代 | 解こうとした問題 |
|---|---|
| Softmax Attention | 過去 N−1 トークン分をそのまま保持する。干渉はないが、メモリ帯域のボトルネックになるほど大きくなる。 |
| Linear Attention | 固定サイズの状態に加算して更新し、O(N) の増大を防ぐ。ただし同じ操作が情報の干渉を生む。 |
| DeltaNet | 「新しい事実を書くとき、その場所にあった古い情報を正確に置き換える」ことで復元可能性を回復。ただし置き換え先が特定できる記憶しか消せない。文脈の切り替えでまとめて消したり、容量を空けるために全体を薄めたりはできない。 |
| Mamba-2 | 前の状態を減衰させてから新しいものを加える。無制限な増大は防げるが、減衰が一律なので「1つだけ忘れたい」ができない(全部が等しく薄れる)。 |
| Gated Delta Rule | 上の2つを合成。パラメータ α が 1 なら純粋な Delta 規則(ピンポイント置換)、0 なら記憶をクリアする。 |
| KDA / Kimi Linear | さらにチャンネルごとに別々の減衰値を学習する(fine-grained gating)。worklog はこれを「この論文の最も重要な貢献」と評している。 |
並べてみると筋が通っています。DeltaNet は「1点を正確に書き換える」ことはできるが「まとめて薄める」ことができない。Mamba-2 はその逆。Gated Delta Rule は両方できるが、薄め方はまだ全体一律。そして KDA は、その薄め方をチャンネル単位まで細かくした —— 消去の解像度が、一段ずつ上がってきたわけです。
だからこそ worklog は「これは闇雲なスケールアップではない」と書いています。K3 で増やした容量には「チャンネル単位で記憶の減衰を制御する」という具体的な数学的目的がある。パラメータを増やしたから賢くなったのではなく、増やした分を記憶の制御に使った、という順序です。
そして同じ発想が、時間方向だけでなく「深さ方向」にも効いているのが面白いところです。
層をまたぐ残差接続もまた、純粋な足し算です。すべての層の出力が同じ流れに足し込まれていくので、後段の層が全体に影響を与えようとするとどんどん大きな出力を学習せざるを得ず、学習が不安定になる。時間方向で起きていたのと同じ「加算による干渉」が、深さ方向でも起きているわけです。
そこで 各項に重みを掛けて「どの層の表現を取りに行くか」をモデルに選ばせるのが Attention Residuals です(12層ごとに配置、推論レイテンシの増加は約2%)。すべての層を等しく扱うのをやめ、いま必要な層の表現だけを選択的に取り出す。やっていることは、時間方向のゲーティングとまったく同じ形をしています。
7年かけて起きていたのは、記憶の解像度を、時間方向にも深さ方向にも上げていく作業だった。— 本記事の読み筋
ここが刺さりました。私は AI エージェントのループ設計で「使い捨ての作業メモリ」と「ラウンドをまたぐ長期記憶(LEDGER)」を物理的に分ける、という設計をずっと使っています。
アーキテクチャの側でも、結局のところ「有限の記憶に何を残し、何を捨てるか」という同じ問題を、gating・decay・選択的読み出しという形で解いていた。レイヤーはまったく違うのに、問題の形が同じなのは面白い偶然でした。
§7実装者として持ち帰ったもの
最後に、我々の開発に直接効きそうだと思った点を3つだけ。
③ について補足すると、なぜ普通のコンテナではダメだったのかが正直に書かれていて面白いです。エージェントは能力が上がるほど大胆に探索し、報酬ハッキングすら試みる。実際、初期実験では意図しないエージェントの操作でカーネルパニックとデッドロックが複数回発生したそうです。かといって探索を縛れば能力が落ちる。「ディスクをマウントし、コンテナを動かし、仮想マシンすら起動できる」現実に近い環境を、隔離を保ったまま与えるために microVM を選んだ、という筋の通し方でした。
§8おわりに
数字としては「2.8兆パラメータ」「100万トークン」「22,580倍」がキャッチーですが、読み終えて残ったのはもっと地味な2つでした。
ひとつは、比較を公平にするための手間。もうひとつは、有限の記憶から何を捨てるかという設計の系譜です。どちらもスケールの話ではありません。
「大きくすれば強くなる」で説明を終えてしまうと、この7年で本当に積み上がったものを見落とす。そんなことを考えさせられる Kimi チームからの報告書でした。
- Kimi Team「KIMI K3: OPEN FRONTIER INTELLIGENCE — Technical Report of Kimi K3」(全47頁)。モデル重みは HuggingFace
moonshotai/Kimi-K3で公開。 - worklog「From GPT-2 to Kimi3, Explained」(@waterloo_intern, 2026-07-28)
- 本記事の読解範囲は、報告書の Abstract・§1〜§4・インフラ章の要所・結論および一部 Appendix です。
- 繰り返しになりますが、本報告書は査読を経ておらず、数値はすべて開発元の自己申告です。
